2026 年,AI大模型已经强到能写代码、能画图、能当程序员助手。在工业软件圈子里,几乎每个人都在谈 AI Agent。
过去几个月,我一直在思考一件事:检测软件(三坐标/光学扫描/GD&T 评价)到底该怎么做 AI Agent?全自动生成检测流程很诱人,但聊了一圈一线工程师后,我发现方向搞反了。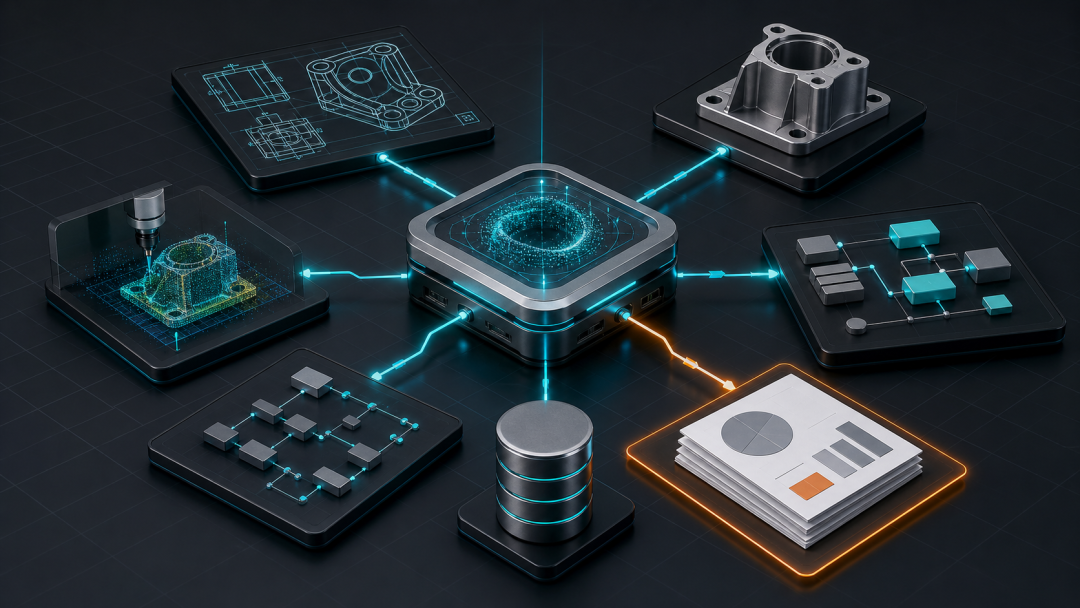 如果你也在做工业软件的智能化,希望这篇文章对你有启发。
一、工程师缺的从来不是"少点几下鼠标"
很多做 AI 的产品经理,第一反应是"帮工程师省点击次数"——AI 一键跑完检测流程,人等着看报告就行。 但真到现场,你会发现,工程师根本不排斥点击。他们排斥的是"不知道下一步该点什么"。 检测工作的真实门槛是以下问题:
检测顺序怎么排?
先粗对齐还是直接建基准?哪些要素必须先验证——因为后面所有评价都依赖它?
每个要素怎么确认?
基准面选得对不对?拟合范围有没有把倒角卷进去?参考点密度够不够?
出问题怎么停?
色谱图一片红,该怀疑装夹、数据还是工件?(基准面不合格,后面全白测)。
工程师对结果签字负责,他们必须全程在场、逐步确认。他们不需要一个替自己干活的黑盒,需要一个帮他们理清策略的副驾驶。 所以,我们的产品哲学被校准为:赋能人,而非替代人。
二、AI 只能当调度员,绝不能当计算器
检测行业有条铁律:结果必须确定、必须可追溯(计量认证的逻辑)。AI大模型天然是概率系统。这两者之间,必须画一条红线。大模型只做它擅长的——理解意图、规划流程、生成调度指令;测量计算永远归确定性内核执行。
AI 输出的永远是"调用最佳拟合对齐、约束基准 A-B-C"这样的调度指令,真正的拟合、对齐、公差计算,由经过认证的算法完成。AI 的引入,不能动摇计量的可信性。双重校验:AI 生成的计划须经确定性规则校验后方可执行。以及四不做清单:不自研大模型、不做模型微调、不自研 Agent 框架、不做全自动无人值守。 不是保守,是敬畏物理世界。代码写错了可以 git revert,装夹错了得重新动手。检测的"执行"连着物理世界,确认密度天然更高。
三、AI 副驾驶:以规划为核心、调度为辅助
基于上面的痛点和红线,我们给 AI Agent 的职责做了一个精确定义: 核心(规划):根据检测目标与当前检测状态,为用户规划下一步目标、或达成既定下一步目标的方案,并给出理由。 辅助(调度):方案经人确认后,由 Agent 调度软件功能完成该步骤的执行——单步短链、无确认不调度。plan(整体目标,下一步目标,检测状态) → (目标 | 方案) + 理由execute(已确认方案) → 调内核 API 完成本步骤异常处理也被框架自然涵盖:执行结果超差 → 检测状态更新 → Agent 重新规划下一步("先解决平面度问题")→ 输出对策方案。异常不是特殊逻辑,是"状态变化触发的重新规划"。四方各司其职:Agent 出策略 → 人做仲裁 → Agent 调度执行 → 内核做状态转移 → 回到 Agent。谁也没有越界。
四、为什么"步进循环"是检测场景的宿命
产品形态被挤压为步进循环——每回合:AI 提议下一步+理由 → 人确认/调整/换方案 → Agent 调度执行+视图联动 → AI 判读结果+放行建议 → 提议下一步。 这个循环与 Claude Code、Codex、Kimi Code 等编程 Agent 的 HITL(人在回路)步进循环本质同源。不是发明新范式,是把已被大规模验证的范式迁移到检测领域。逐项对应:
编程 Agent
| 检测 Agent
|
读代码库
| 读对象清单
|
diff 预览 + 人确认
| 计划卡片 + 视图高亮 + 【确认执行】
|
执行(写文件/跑命令)
| 内核执行(对齐/拟合/评价)
|
看测试结果/报错
| 结果判读(残差/公差比对)
|
报错归因重试
| 异常归因 + 对策选项
|
git checkpoint
| 工程快照 + 审计日志
|
项目记忆文件
| 检测工艺知识库 + 模板沉淀
|
但检测版是"保守变体",三个关键差异:
物理世界不可逆:代码可回滚,装夹/基准错了无法一键撤销;没有"测试"兜底:代码有编译器自动拦截,检测合格判定只能靠工艺知识+人;审计是合规要求:计量可追溯是产品准入证,不是 nice-to-have。由此推导出信任等级光谱:
等级
| 模式
| 调度链条
|
Level 1
| 每步必确认
| 1 步
|
Level 2
| 低风险连跑,关键节点确认
| 几步
|
Level 3
| 模板场景整段自动,异常唤醒人
| 整段
|
光谱最右端是编程 Agent 的全自主模式——检测场景永远不到达。信任每涨一级,链条放长一节。
五、真正抄不走的护城河 = 隐性知识 × 系统绑定
产品形态能被看见,就能被模仿。竞争对手也能内嵌同一个 CLI、画出同样的面板。真正的问题是:做出来之后凭什么赢?先做能力盘点:
能力
| 归属
|
步进循环骨架、代码生成、语言理解
| 借:CLI + LLM 开箱即用
|
检测策略知识、异常归因、健康标准
| 造:检测工艺知识库
|
视图联动、审计日志、校验护栏
| 造:能力层 + UI + 护栏
|
借的部分全是通用能力,模型升级跟着受益;造的部分全部长在领域 know-how 上——这个分工就是碾压测试三问全过的原因。
但这里有个更深层的问题:知识库本身也有被大模型消化的风险。知识分层来看:
知识层
| 会被消化吗
|
显性知识(标准/文献)
| 会,且已发生
|
半显性(最佳实践/SOP)
| 逐渐被消化
|
隐性知识(踩坑规则/决策日志)
| 不会——不在任何公开语料里
|
单纯以"知识内容"形态存在的资产,护城河有保质期。真正的壁垒是知识库与软件系统的四重绑定:
表达绑定:规则以私有对象 ID 体系、API 语义、封闭词表书写——模型学会工艺也写不出在本系统直接可执行的形态;验证绑定:规则的效果分依赖本系统的执行环境与数据回流——抄走文本,没有验证环境,规则是死的;生产绑定:知识的原料是"按钮+参数+结果"的结构化交互日志,只在自家软件里产生;消费绑定:规则经上下文注入驱动自家 API——脱离软件的知识库只是一堆文档。护城河公式:护城河 = 隐性知识(模型够不着)× 系统绑定(离开了跑不动)
这与 Cursor 的护城河逻辑完全同构:值钱的不是"懂代码",而是知识绑定在索引、集成、交互与工作流上——模型换了几代,绑定层纹丝不动。
六、每一次人机交互,都在为知识库添一条规则
关键认知:AI 副驾驶的交互不是自由聊天,而是"按钮+参数+结果"的结构化闭环——数据天生干净,无需 NLP 挖掘。每次交互零成本落库:场景 / AI 提议 / 人的响应 / 执行结果 / 后续验证。① 自动记录 → ② 信号识别 → ③ 聚类归纳 → ④ 确认入库 → ⑤ 反哺验证(零打扰) (找知识信号) (AI辅助) (人把关) (效果跟踪) 工程师张工在检测沉头孔时,把 AI 默认的"全长拟合"改为"中段拟合"(避开倒角段)。这个动作被自动记录为"参数调整信号"。 90 天后,系统聚类发现:同类调整出现了 6 次,跨 3 个用户,结果全部良好。AI 生成候选规则:"沉头孔类特征,拟合范围默认避开倒角段 ±1mm"。 从第 91 天起,新人小李遇到同类件,AI 的建议参数直接就是对的——他甚至不知道这条规则来自张工踩的坑。 一年后,这条规则被应用 200+ 次,自动进入培训教材。飞轮效应:用得越多 → 知识库越厚 → 建议越准 → 越离不开。飞轮转的不是模型权重,是越来越厚的"检测工艺规范"。分层归属防污染(公司级/客户级/个人偏好三层注入);一份提炼两个形态(机器版进提示词,人类版进培训教材)。
写在最后:做模型的地主
大模型 = 电网,软件 = 工厂。发电厂技术进步不会清零工厂,电越便宜工厂越受益——前提是拥有工厂,而非自制发电机。 模型军备竞赛的每轮炮火,都在帮我们免费升级产品。大模型基座不在手里,恰是路线成立的原因,而非风险。每次 Agent 投入立项前,用三问自查:
模型明天强 10 倍,该投入增值还是贬值?
模型厂商有动机与能力做这件事吗?
该价值是否依赖"模型当前的缺陷"?
模型不会清零认真做产品的人,但会奖励先动手的人。不可逆的落后只发生在一种情况:观望过久,竞品先把工具层做进了客户的 Agent 生态。